SHOTLINE / BEFORE THE FIRST FRAME
Shotline 分镜制作
把一个故事想法逐步转化为剧本、
镜头设计与视觉分镜的 AI 创作工具。
我为什么做这个
2026 年初,Seedance 2.0 的推出让 AI 视频生成迎来了一波新的增长。
模型能力迭代飞快,但围绕 AI 视频创作的基础设施却没能同步跟上。即梦等平台依然主流采用对话式(Chat)界面:创作者需要通过一轮轮 Prompt 描述镜头、修改细节,然后陷入漫长的等待。
大家真正面临的困境,其实并不是“不会写 Prompt”,而是:每一次错误的生成,代价都太高了。
当时视频生成算力极其紧张,即便开了高阶会员,提交一个任务依然要排队很久。对于创作者而言,一次偏离预期的生成,浪费的是极其宝贵的时间、算力和有限的额度。
在传统的“抽卡模式”(先生成一个看看,不行再抽一次)下,这种高昂的等待时间让创作效率断崖式下跌。我逐渐意识到:生成前的决策质量,正在变得和模型能力本身一样重要。
视频生成前的问题
很多 AI 视频的失败,根源并不是模型画质不够好,而是问题早在生成点击前就埋下了。
一个看似完整的 Prompt,往往根本没有解答这些专业影视镜头问题:
-
这个镜头为什么存在?它和上一个镜头是什么逻辑关系?
-
什么时候该切镜?景别切换的依据是什么?
-
人物的入画方向、摄像机是推还是静止?
-
复合动作应该拆成几个镜头,如何共同推进叙事?
如果生成前没有厘清这些逻辑,再强大的模型也只能忠实地生成一个好看却逻辑混乱的镜头。
与其继续研究“怎样写出更长的 Prompt”,我决定换个方向:看看专业影视创作是如何决定一个镜头该长什么样的。
从影视制作中学习
我系统学习了市面上 9 门高质量的分镜与影视镜头课程。但我没有简单地把它们整理成一份静态知识库,而是尝试提取其中跨场景、可复用的判断逻辑:
-
什么时候用远景表达环境,什么时候切近景捕捉情绪?
-
一个动作应该在一镜到底中完成,还是拆解成组镜?
-
镜头间如何维持空间轴线与视线的一致性?
-
运镜是在补充信息,还是纯粹在制造无意义的噪点?
我把这些散落在影视经验里的法则重新抽象,翻译成一套可被大模型精准执行的规则体系,最终形成了 Shotline skill。
把知识变成工作流
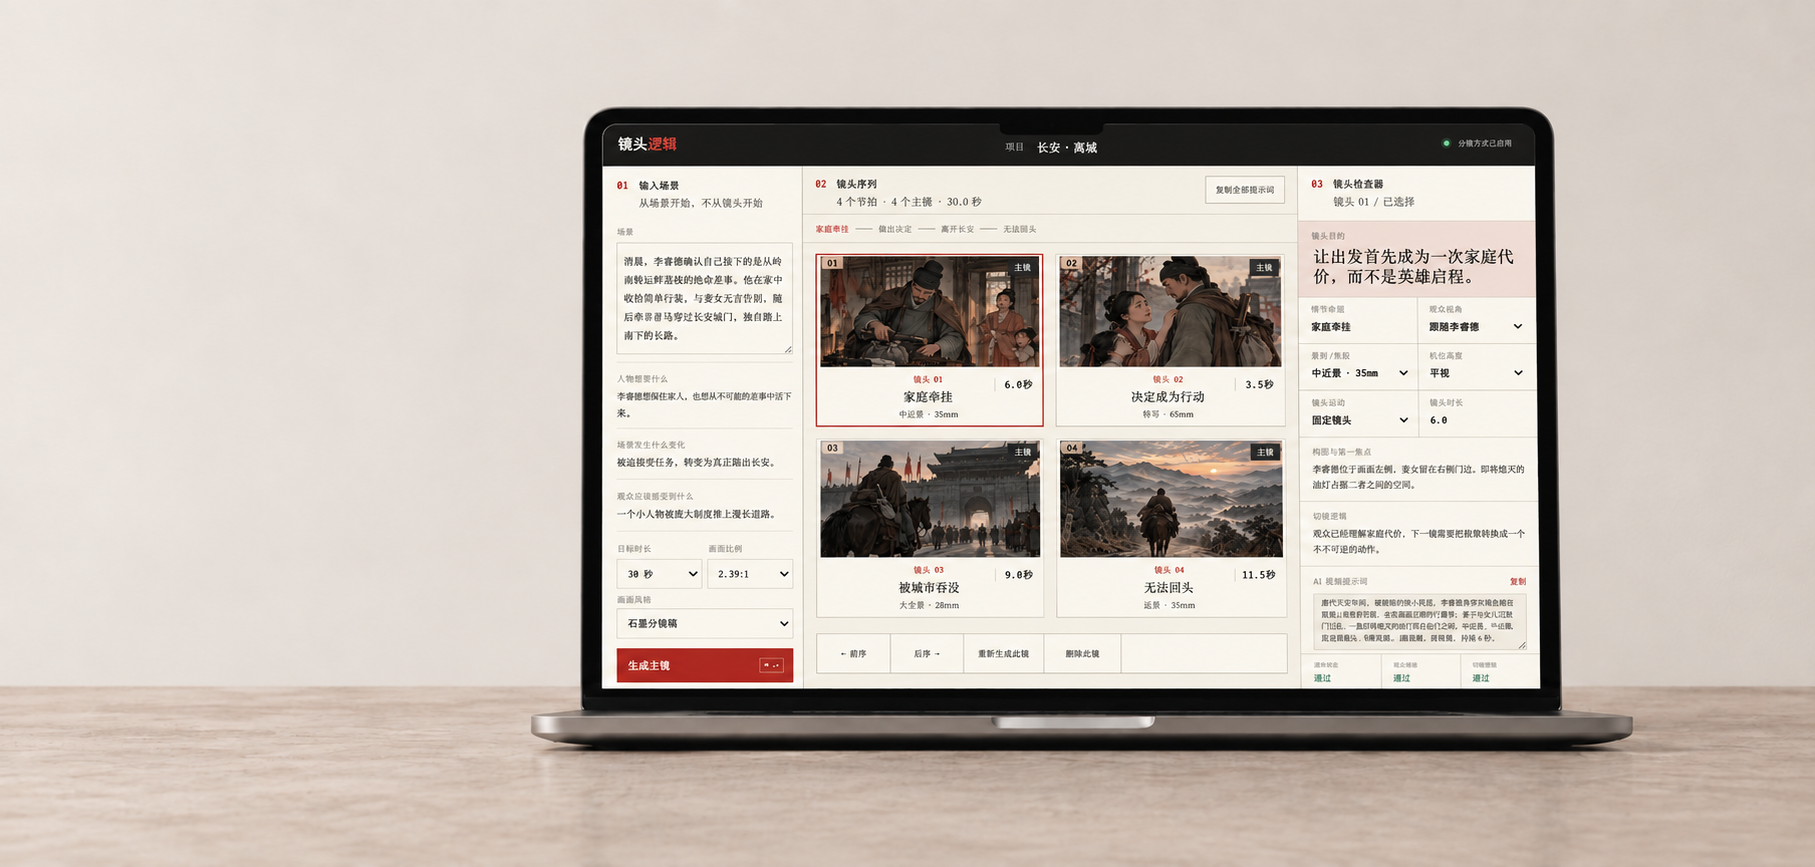
这个 Skill 的核心目标不是教 AI“懂电影”,而是让模型在调用视频生成前,先完成一次结构化的镜头设计。
当用户输入一个故事、广告创意或视频概念时,Skill 会按顺序完成前置拆解:
-
叙事核心:拆解这一段剧情真正需要表达的核心信息。
-
切点提取:确定哪些动作与信息变化值得拆分为独立镜头。
-
镜头语言:明确每个镜头的景别、角度、构图与镜头组接逻辑。
-
连续性校准:检查前后镜头中的人物位置、视线方向与空间一致性。
-
运镜设计:精准定义推进、跟拍、摇移或静止。
-
Prompt 转化:最终将其翻译为最适合 AI 视频模型理解的生成描述。
它将原本充满不确定性的工作流,做了一次重构:
以前:想到一个画面 → 直接生成 → 不满意 → 重新抽卡
现在:镜头设计 → 检查影视逻辑 → 确定无误后再生成
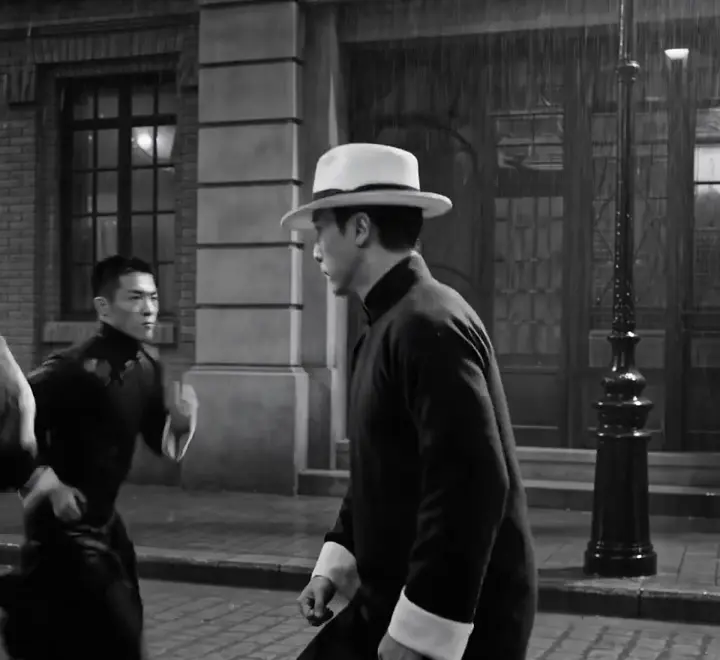 ▷ 播放动图Ⅱ 收起动图15 秒 / AI 生成片段
减少失败的成本
Shotline Skill 真正想要降低的,并不是 Prompt 的字数,而是一次错误生成发生的概率。
如果视频生成零延迟、零成本,多试几次固然无妨;但在当时的环境下,降低 Cost per usable shot(获得一个真正可用镜头所付出的平均成本)才是提效的核心。
这也是我第一次意识到:AI 创作工具的效率,绝不该仅仅用“生成速度”来衡量,更应该看“多少次生成能真正进入最终成片”。
为什么是一个Skill?
我没有选择把它做成独立的 Web 平台或复杂编辑器,因为当时行业最缺失的并不是又一个生成界面。
模型和工具都已经存在,真正断层的是连接“创意 → 分镜 → Prompt → 视频生成”之间的那层中间件。
以 Skill 形式切入,能够无缝嵌进创作者原有的 AI 工作流中。它就像一层 Pre-generation Intelligence(生成前智能):它不直接生成视频,但它负责让你的下一次生成更有把握。
结果和反思
Shotline Skill 始于我为了解决自身“抽卡卡顿”的痛点,但在完成的过程中,我发现这远不止是一个算力问题。
随着 AI 视频模型演进得越来越强,创作者的重心正在发生转移:从“如何让模型生成一个好看的画面”,变成“我究竟需要什么镜头”。
当模型的执行力不再是瓶颈,人的价值反而更集中到了选择、结构与审美判断上。Shotline Skill 所做的,就是把这部分判断过程提前并标准化。
这个项目也刷新了我对 AI Skill 的理解:真正有价值的 Skill,绝非泛泛地教 AI 完成一项任务,而是把某个领域里极度依赖经验的抽象决策,转化为模型可反复执行的结构。
影视分镜的知识到处都有,难的是把“我看懂了”,变成“面对新需求时,我知道下一步该怎么切”。
Shotline 不是一份关于镜头的知识合集,而是一个压缩了专业分镜经验的决策系统。它解决的从来不是“如何生成更多视频”,而是“如何用更少的尝试,拿到更多真正能用的镜头”。