浏览器里的英语学习
Milo
让阅读里的遇见,留下来。
Milo 是一款浏览器AI翻译插件,与传统翻译插件不同,Milo更像是你的学习搭子,在你使用工具的同时它也能帮助你学习,适用于对专业翻译有需求语言学习人群。
产品的重心不仅放在如何让翻译的内容更好,还有如何能让语言学习者更好的学习。
- 时间
- 2026.09 至今
- 角色
- 独立产品设计与开发
- 当前形态
- 桌面浏览器扩展
- 工作范围
- 需求、交互、实现与验证
不断记录又不断翻找
Milo 的起点,是我高中时用过的一本生词本。阅读时遇见、查词、誊写,刚开始很管用。后来,记录越来越多,翻开的次数却越来越少。少了原来的句子,很多词只剩下一条孤立的中文释义。
当阅读转移到电脑端,查词变得更方便,但这个断层仍然存在。看文章、读帖子、看英文视频时,我可以立刻知道一个词的意思,几分钟后,它又随着页面一起被关掉了。
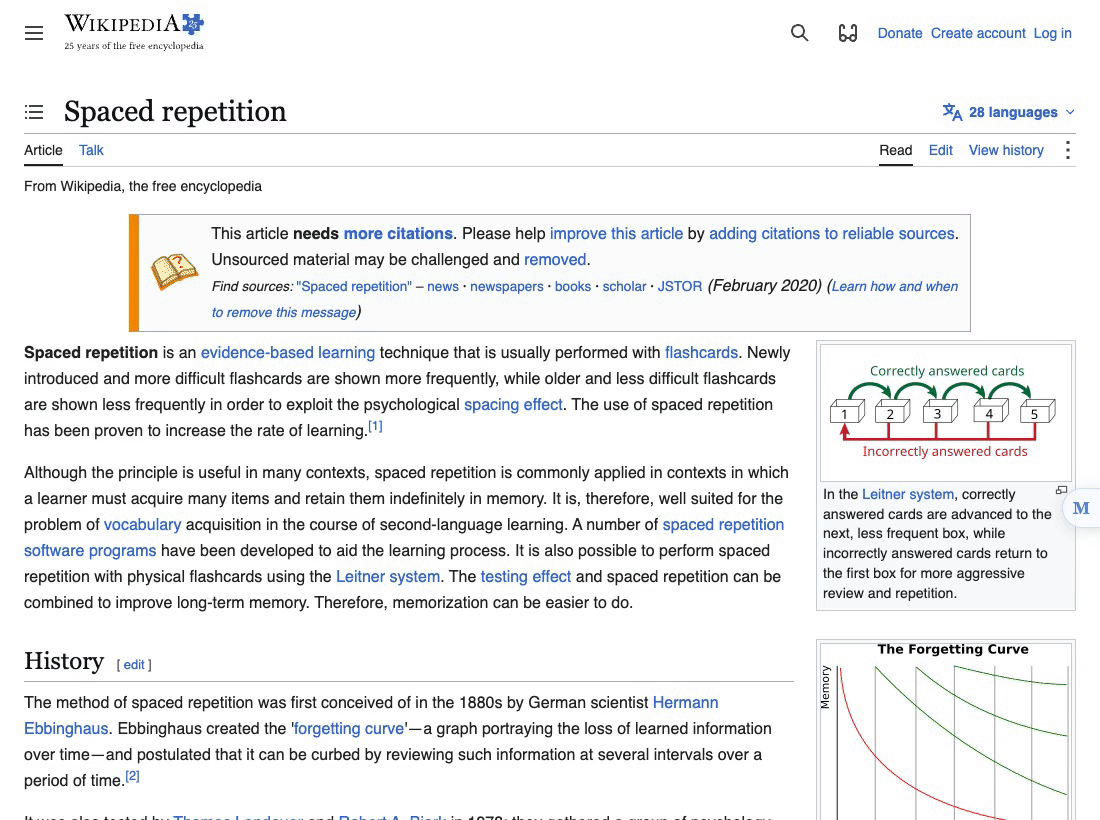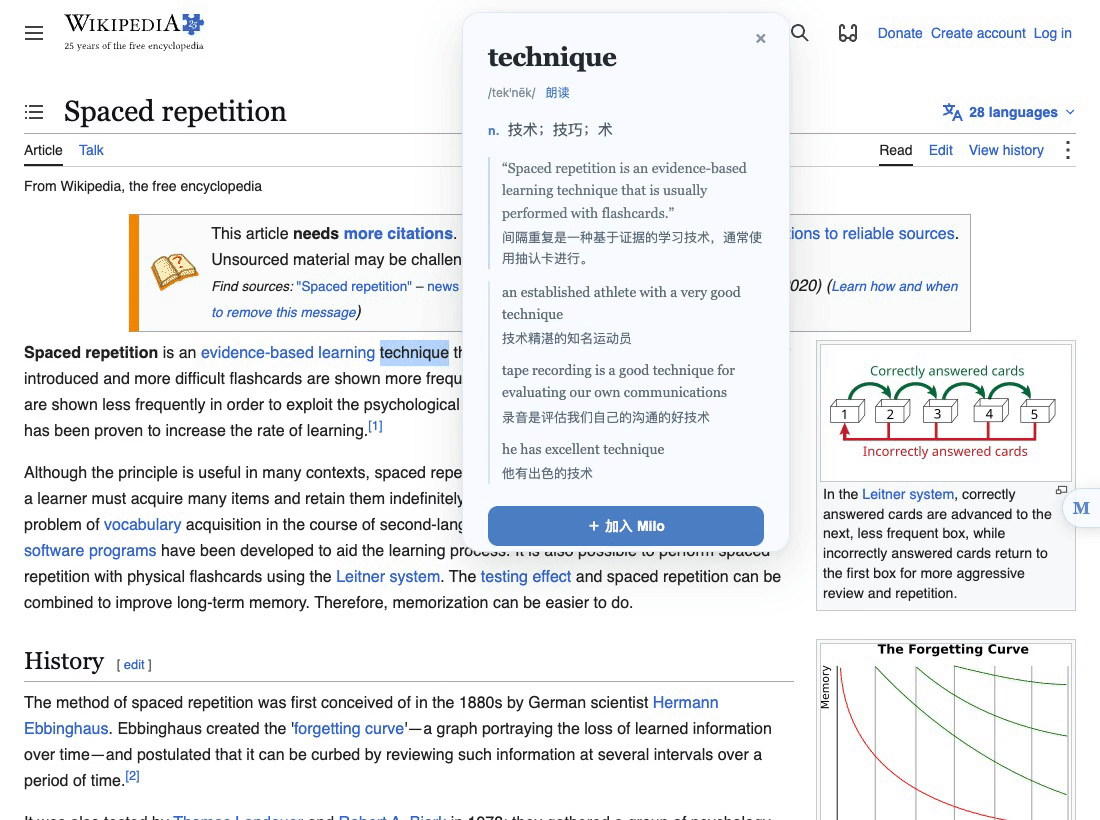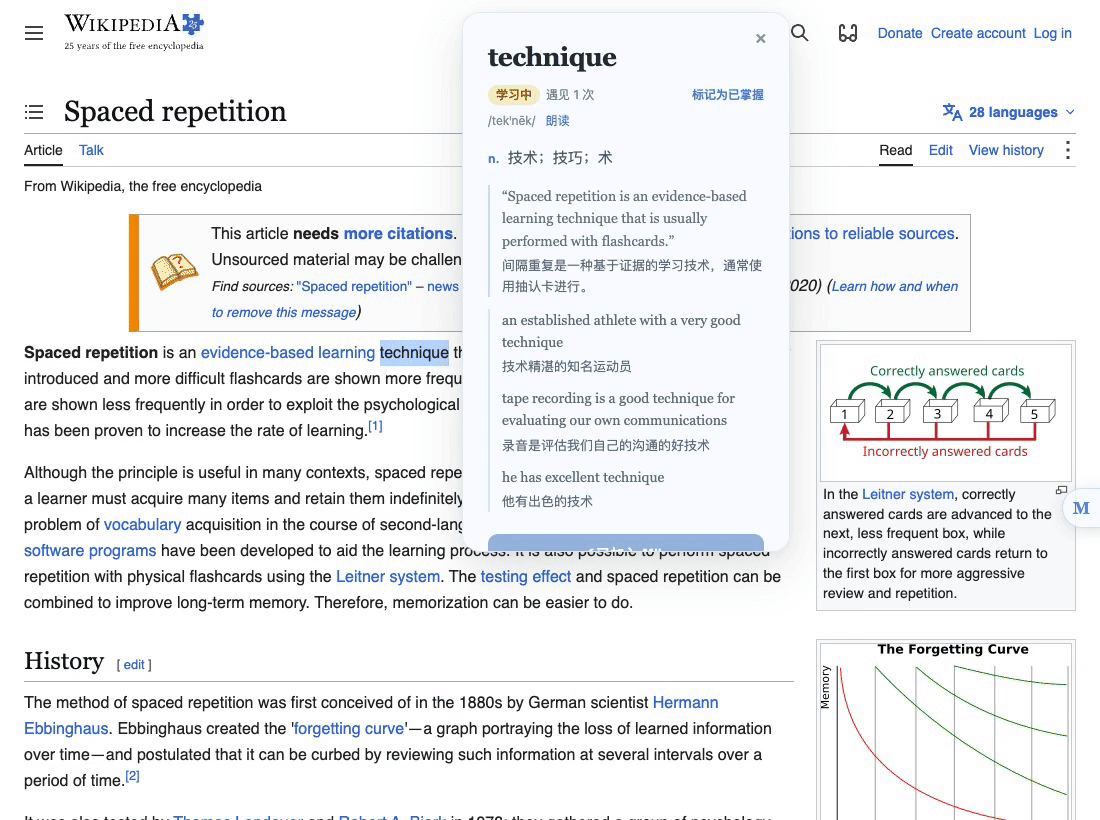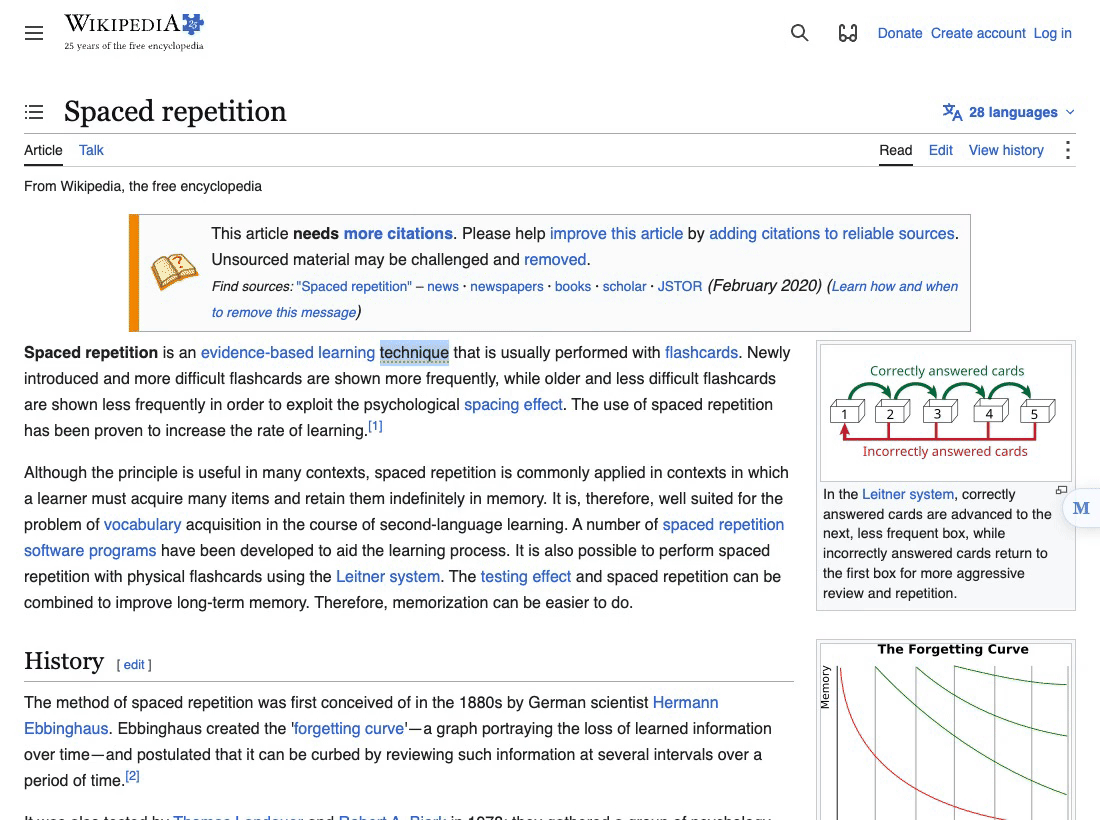
因此,我把 Milo 的重点放在一条连续的路径上:先理解眼前的内容,顺手留下生词和语境,再给它一个能够回来的入口。 翻译、记录和练习,由这条路径连接起来。
可以随时翻译
阅读英文时,始终摆在下方的中文很容易先吸引视线。我想给读者留一点自己理解的空间,也保留随时获得帮助的自由。
Milo 的学习模式会模糊译文,原文保持清晰。读者先看英文,遇到不确定的地方,再把鼠标移到译文上揭示中文。这个小小的停顿,把“什么时候需要答案”的决定交回读者。
对需要快速获取信息的内容,仍可以直接使用双语阅读。学习模式提供另一种可选择的节奏,读者不必每次都练习。
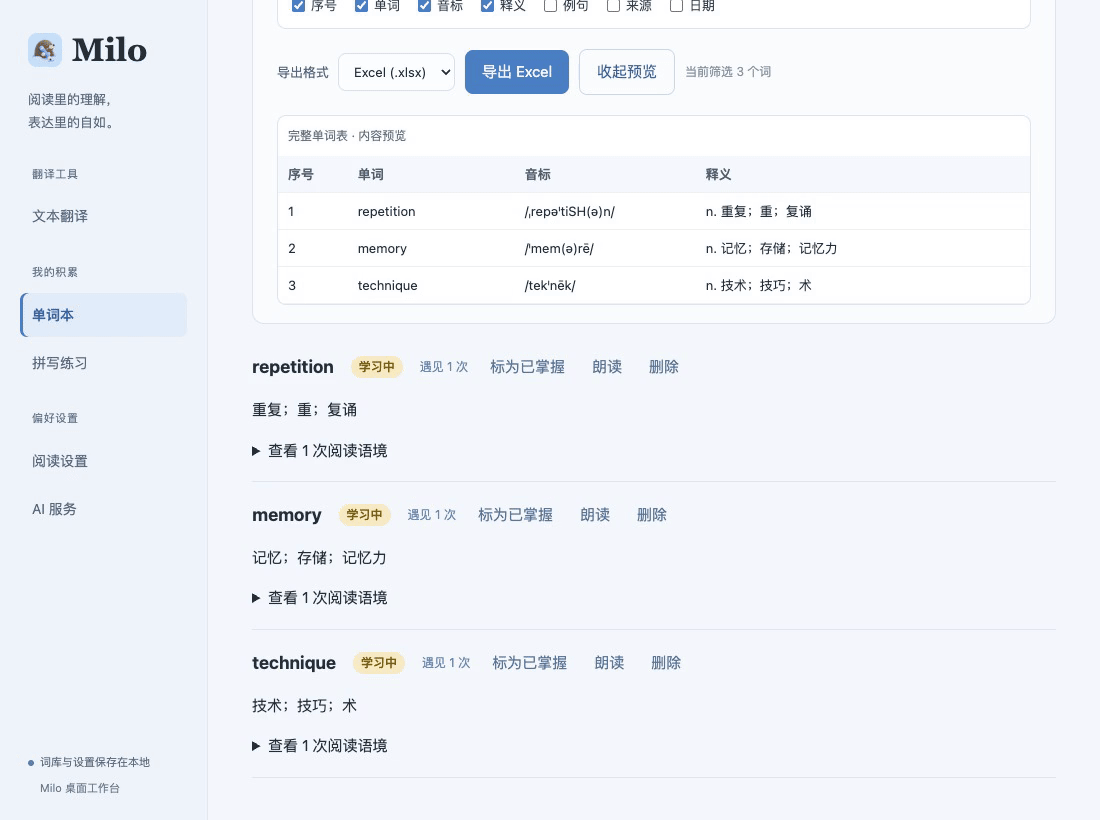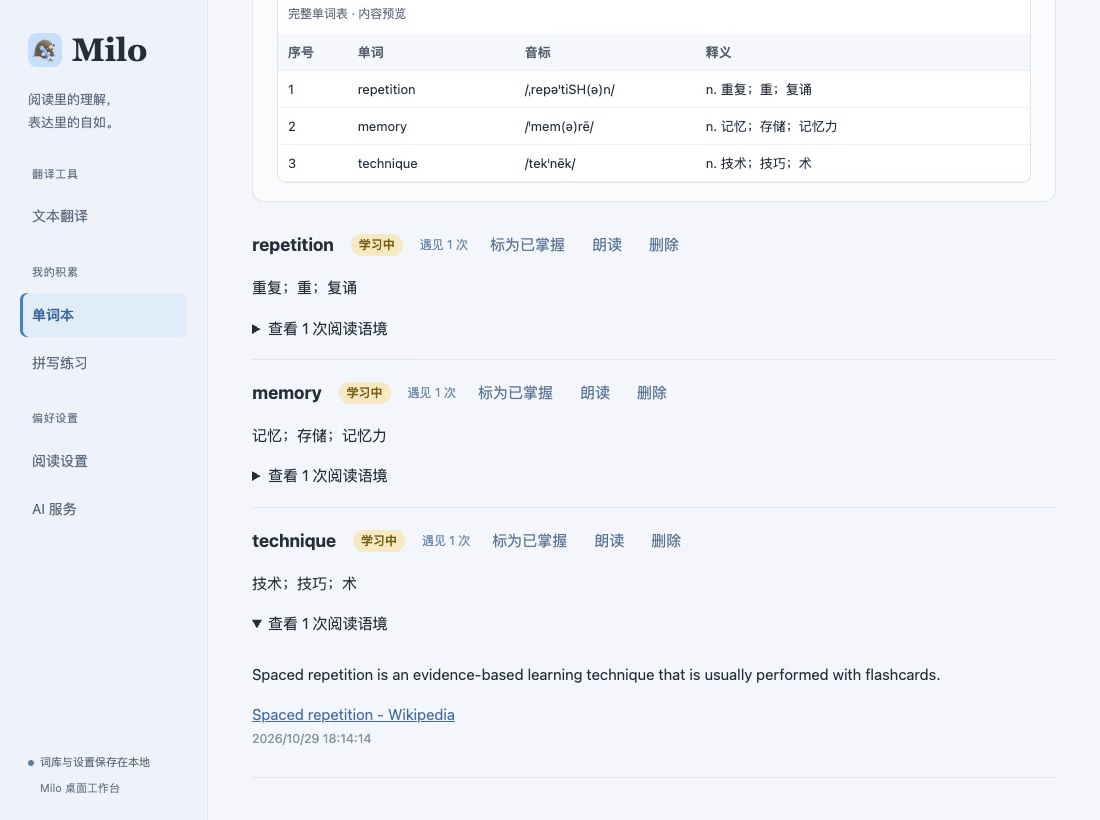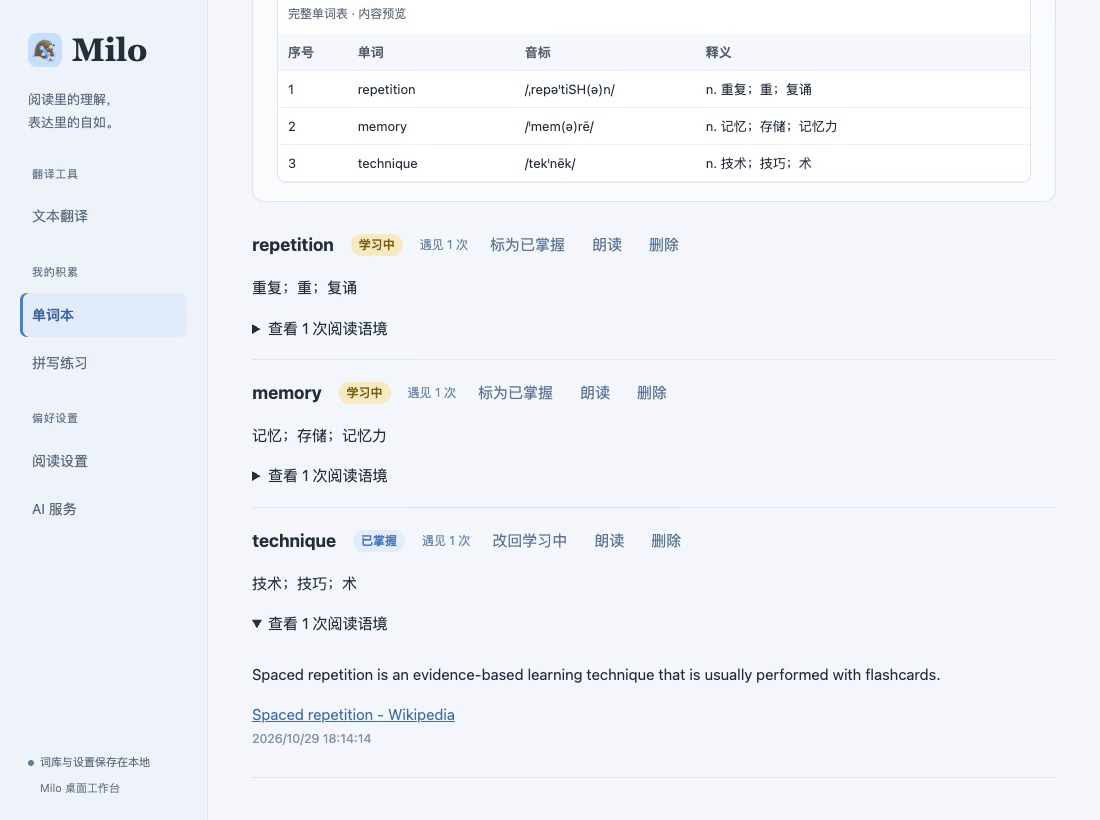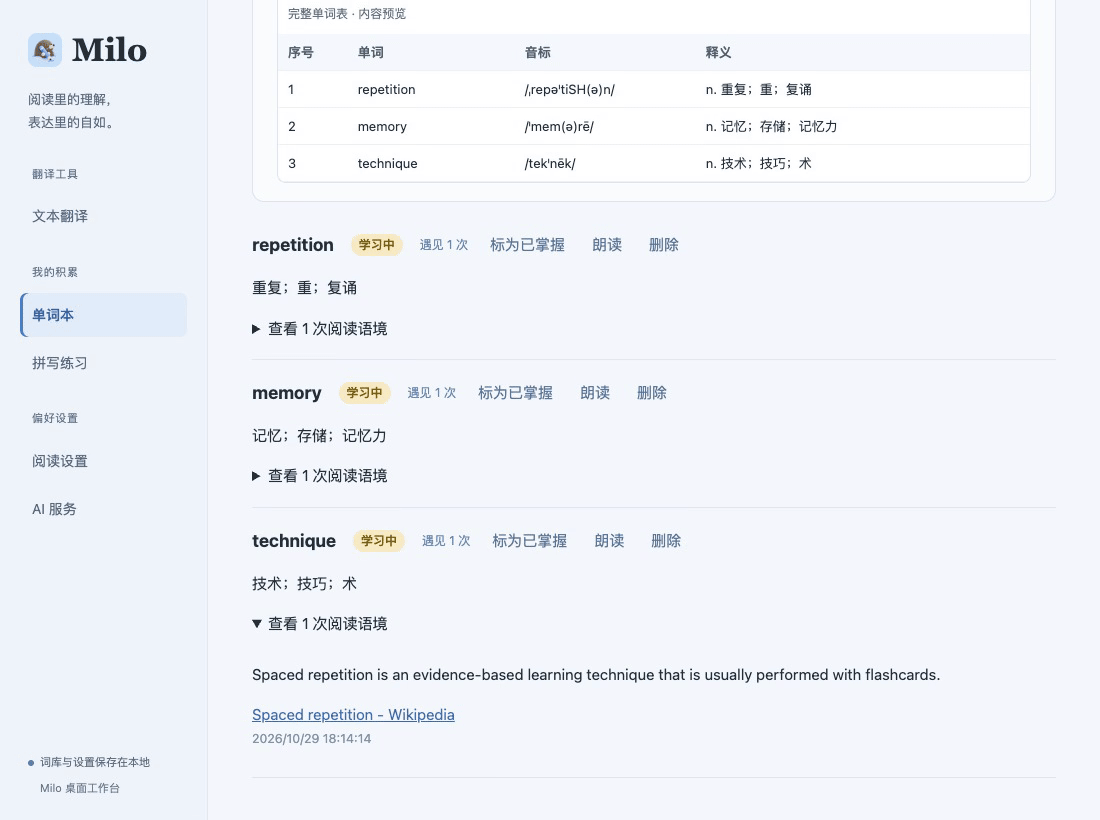
记录一个词,也记录下遇到这个词的语境
收藏一个词时,Milo 同时保存释义、原句、网页标题、来源链接和时间。回看时,读者可以沿着这条线索,找回自己当时为什么需要它。
同一个词再次被记录时,会进入已有词条的遇见记录;学习中的词也可以在后续阅读中被标出。这个列表是由用户的使用经验而不断丰富,而不是从一份通用词表开始。
“遇见次数”记录的是阅读中的接触,不直接代表掌握程度。因此,学习中与已掌握仍由用户自己判断。
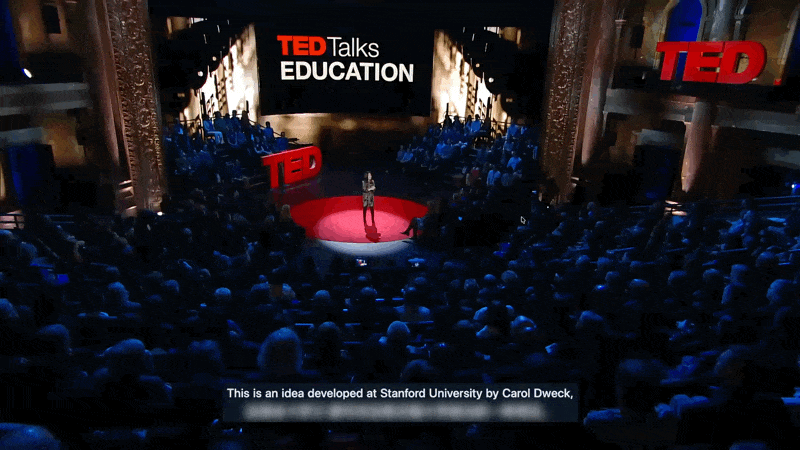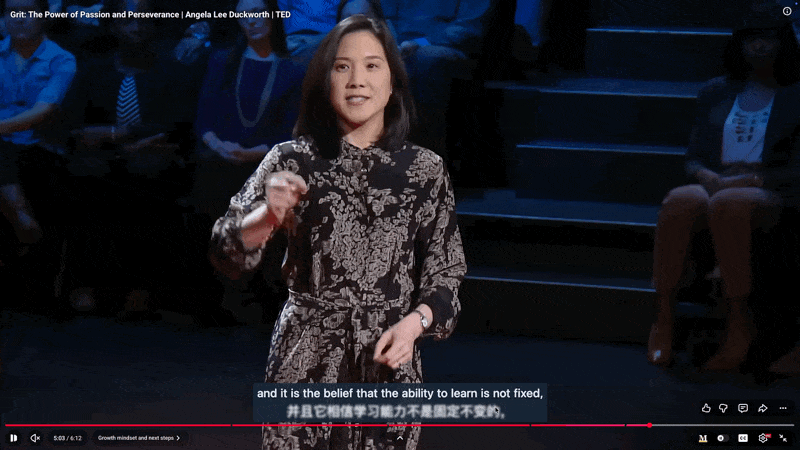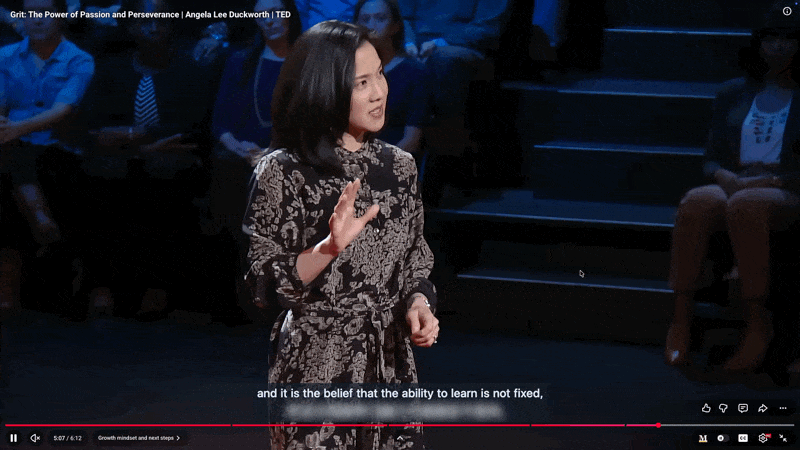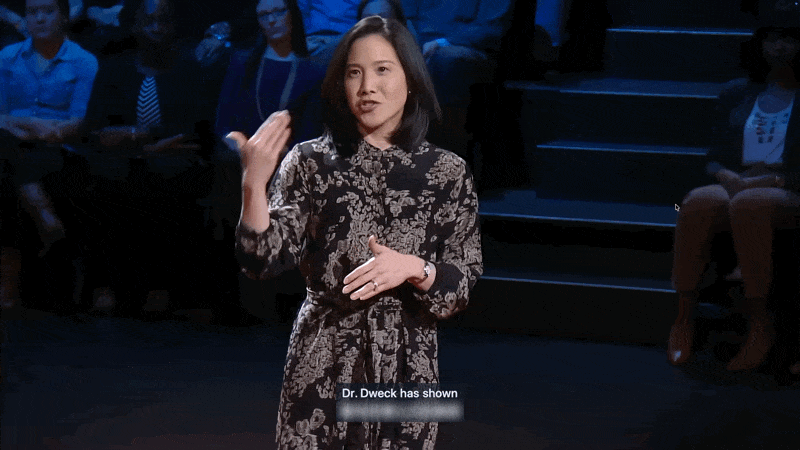
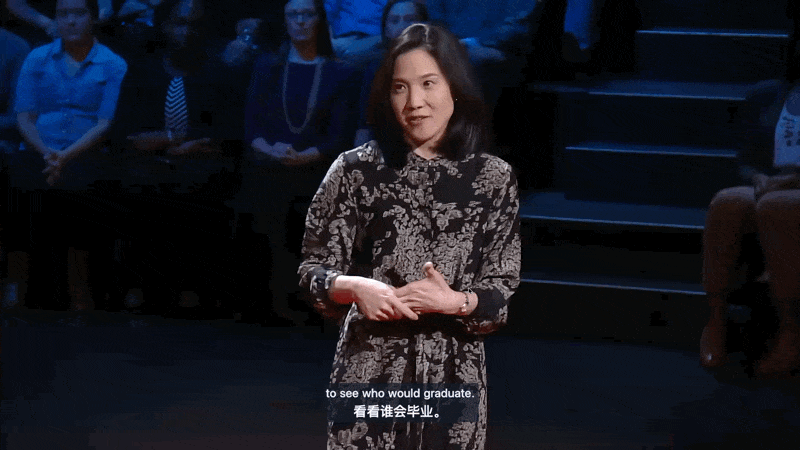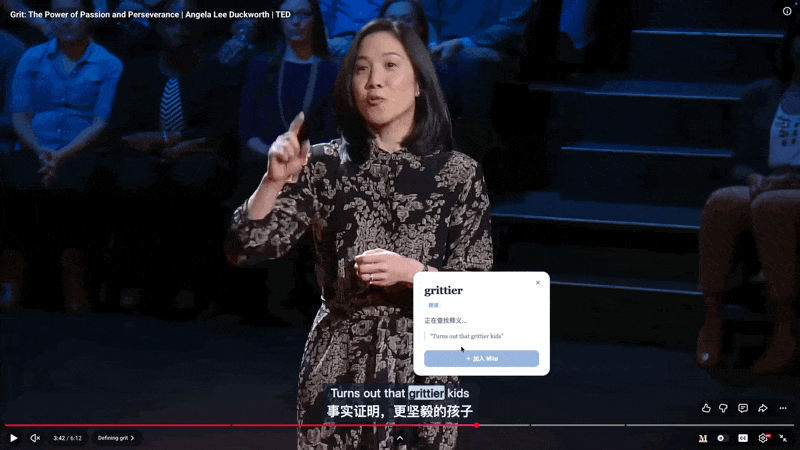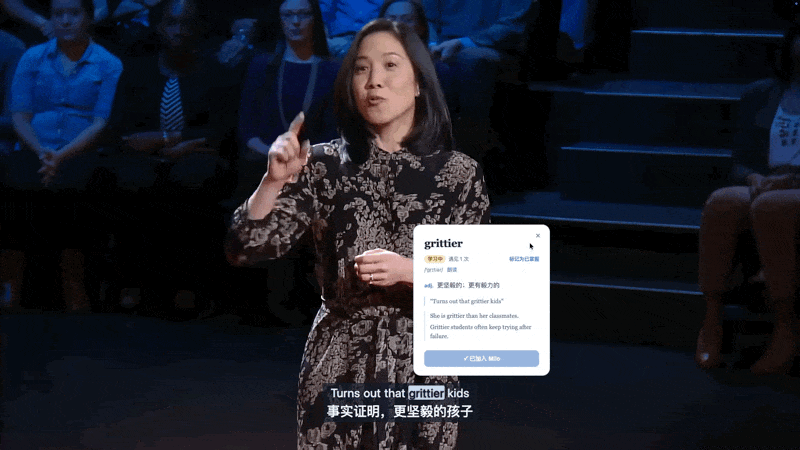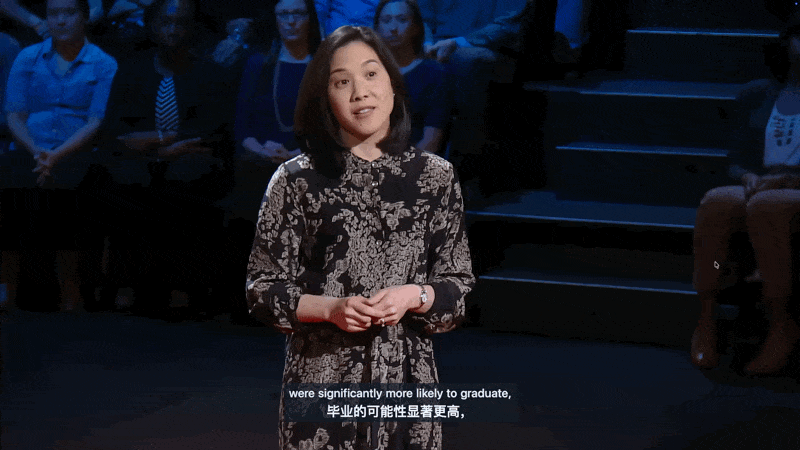
即使看视频也可以随时随地记录单词
在开启翻译的情况下,在观看视频的过程中如果遇到生词,可以随时选中单词并进行翻译和记录。
随时随地练一点
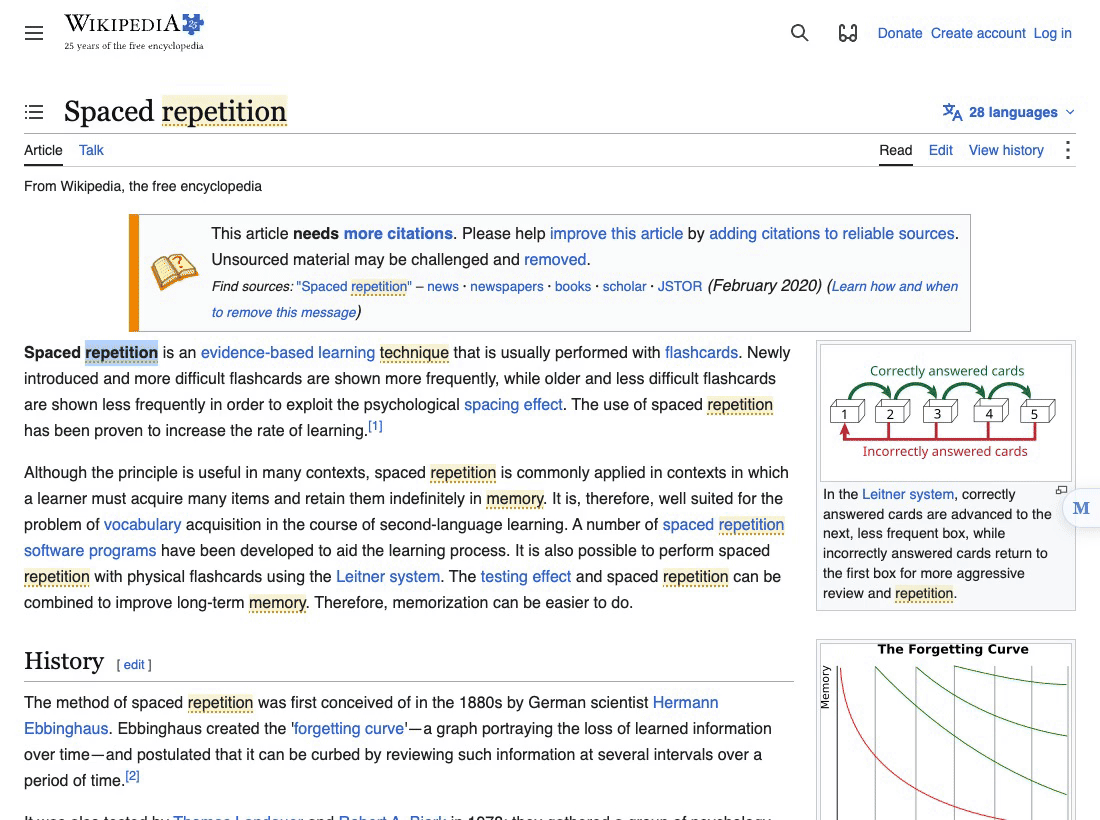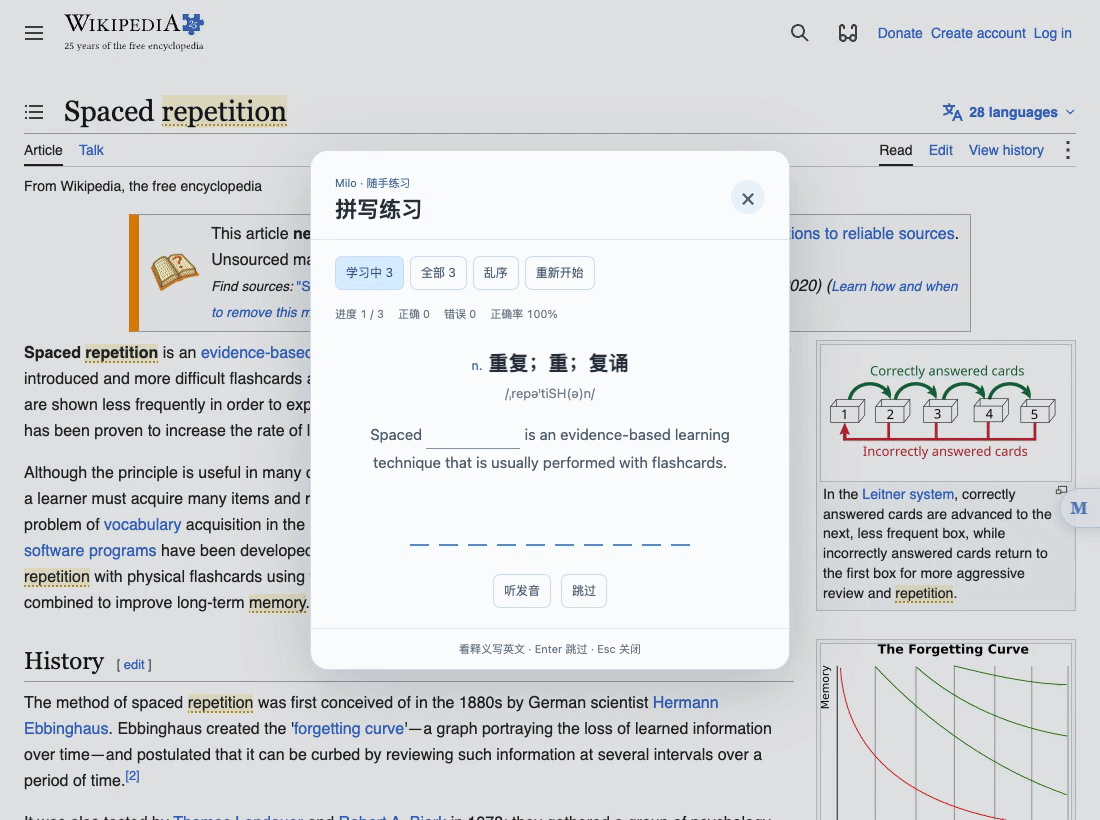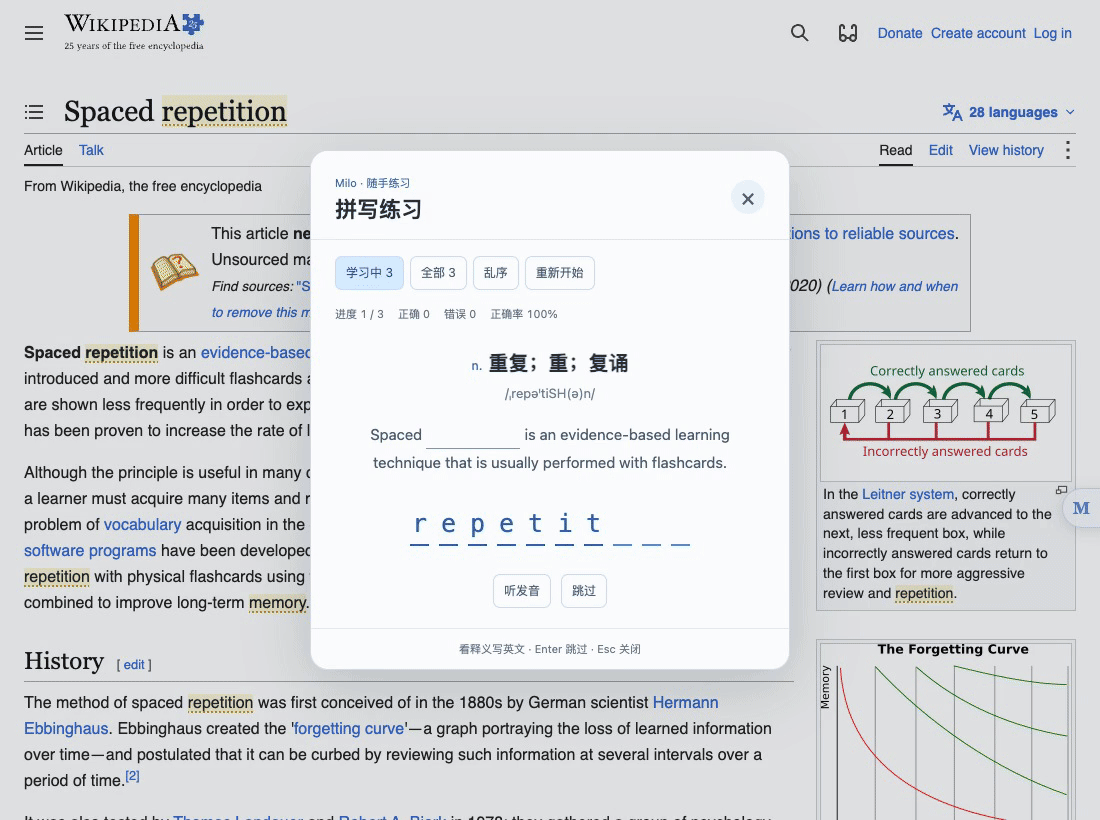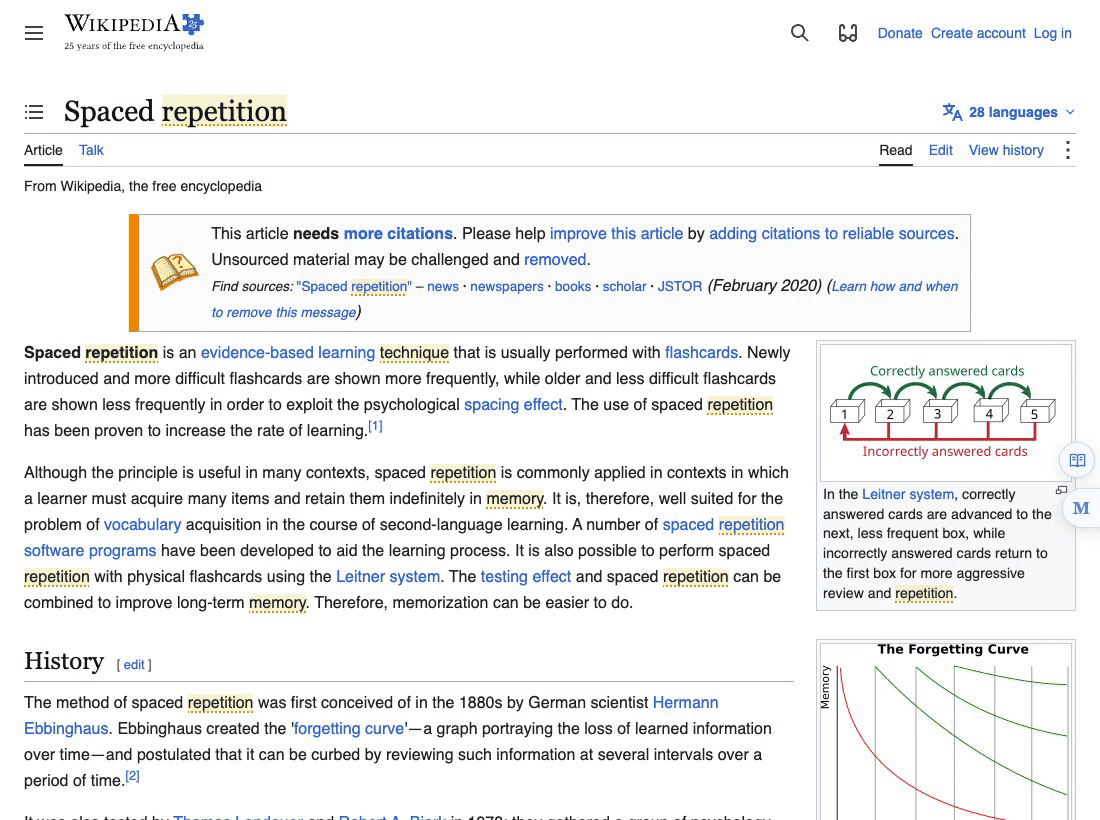
只有记录功能,词汇还是容易停留在表面,用户能随时随地练习或许更好。
在网页右侧的 Milo 按钮上稍作停留,可以进入当前词库的拼写练习,结束后关掉弹窗,继续原来的阅读。单词本里也可以听发音、查看语境,或将词标为已掌握。
如果更习惯纸笔,词表可以导出为 Excel 或 PDF。默写练习支持随机排列,可以看中文默写英文,也可以看英文默写中文。练习的材料仍然来自自己的记录。
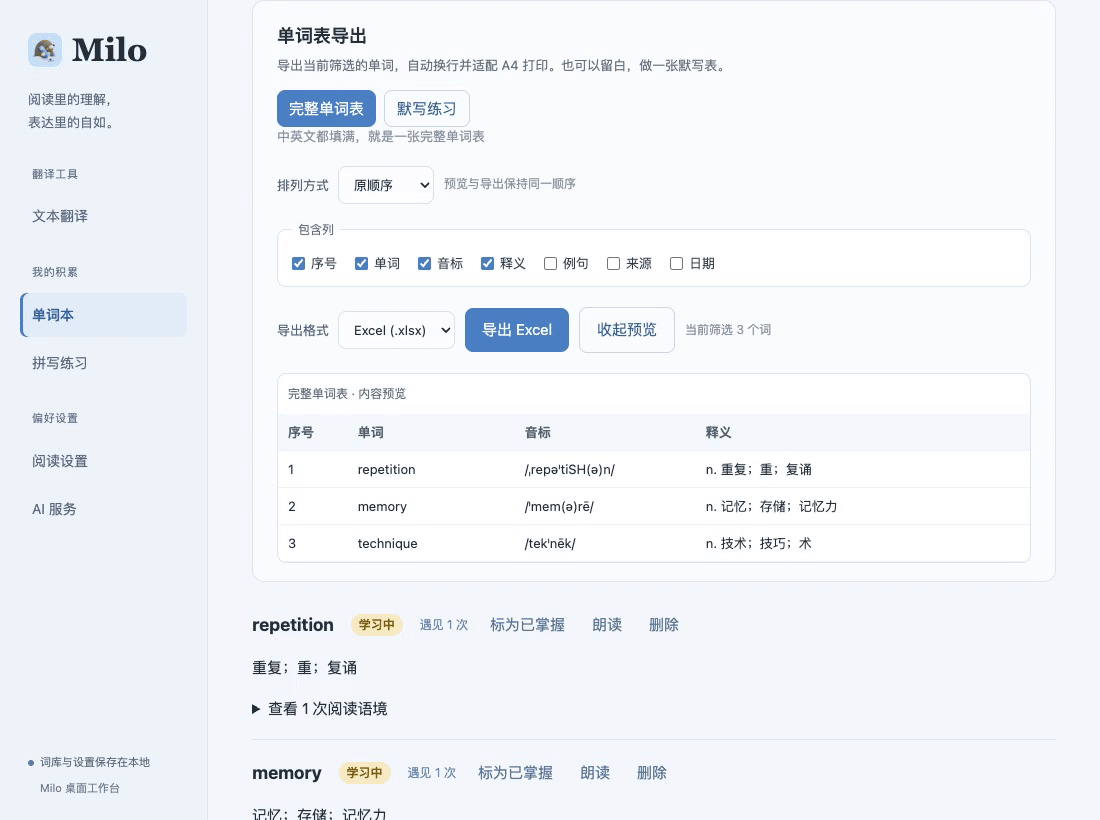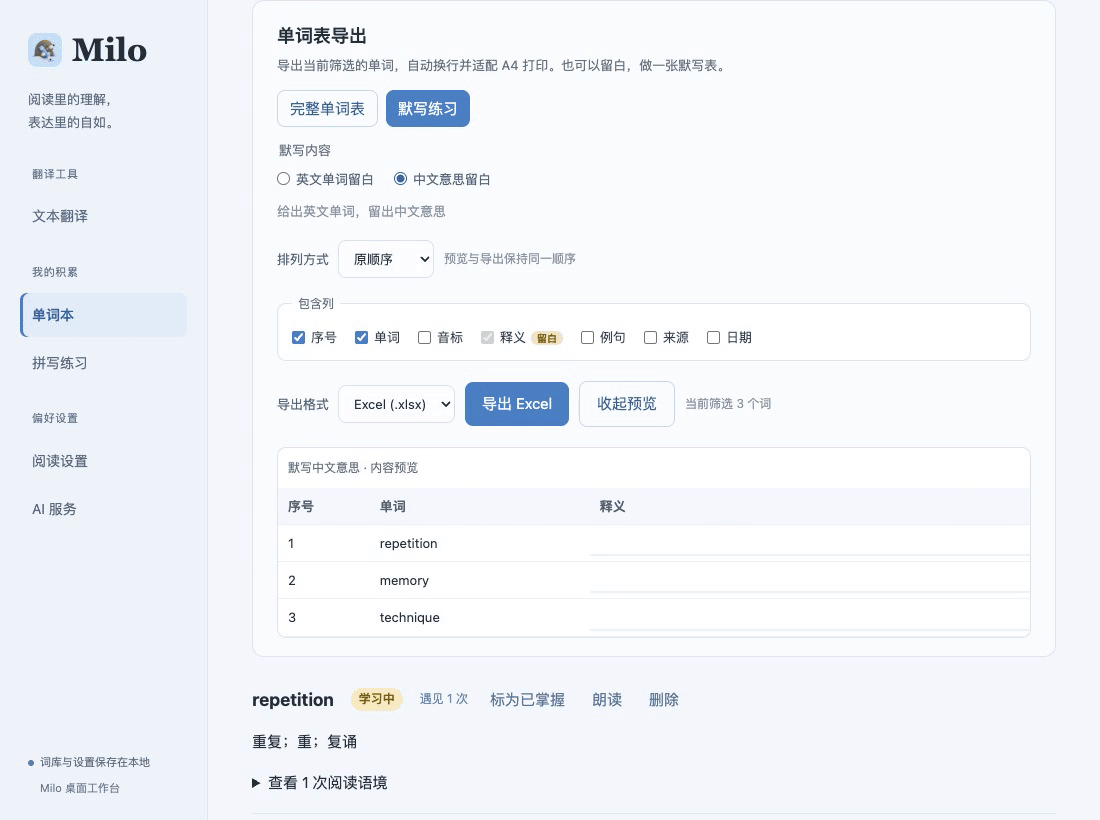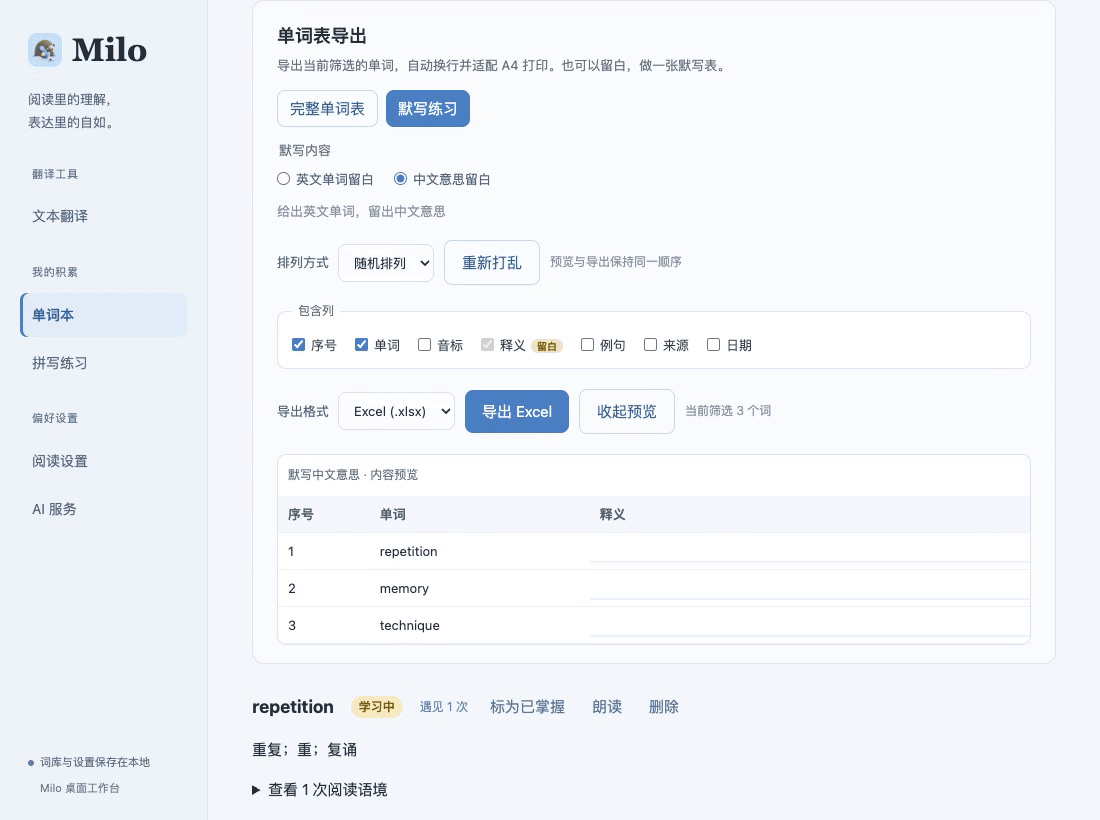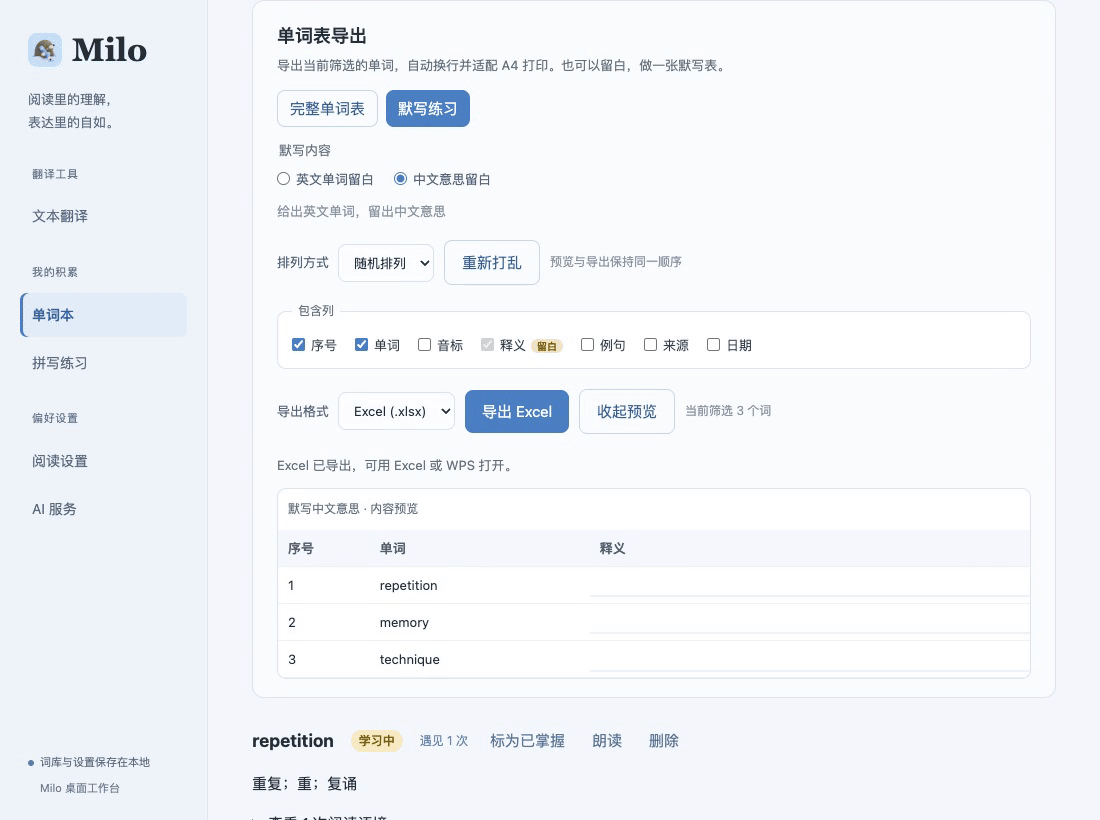
从屏幕,也可以回到纸上
原顺序或随机排列,英文留白或中文留白,再选择 Excel、PDF。练习方式由读者决定。
不为还没读到的内容提前付费
当用户使用自己的模型 API 时,每次翻译都是一次真实的资源消耗。我的优化重点是减少没有必要发送的内容,以及可以共享的重复工作。
网页随阅读位置逐步翻译,字幕按播放位置预取;重叠内容共享进行中的请求,提示与术语表合并发送。关闭或跳转时取消不再需要的任务,重复阅读则尽量复用已有结果。
优化后的收益取决于具体行为。只读开头时,可以避免提前翻译整篇;读完整篇时,后续段落仍会产生用量。因此,我用有明确条件的样本对比展示结果,不把它概括成面向所有用户的固定省费比例。
查看数据与测试条件
| 同一场景 | 优化前 | 优化后 | 总 Token 变化 |
|---|---|---|---|
| 重叠并发任务 | 480 | 305 | 减少 36.5% |
| 4 段正文与相同术语表 | 675 | 324 | 减少 52.0% |
| 完整翻译同样的 8 段正文 | 571 | 575 | 增加 0.7% |
输入与输出 Token 的合计,来自固定样本的真实接口响应;不是日常平均值,也不等于账单降幅。
这轮前后对比共进行了 28 次真实 API 调用。两版使用同一模型,各场景从空的本地缓存开始;每个场景每版测量一次。网页和字幕的按需请求另有“只消费开头”的样本,完整条件与原始用量汇总见记录。
下载完整测试记录(Markdown)仍在继续
从“这次看懂了”,
走向“下次还记得”。
桌面端已经连接起阅读、记录和练习。接下来,我会继续优化插件在不同网站的可靠性、以及翻译的稳定性、翻译质量的提升以及Token成本如何继续进行优化等问题,该插件将在不久上架Google。
实录原文:Wikipedia 贡献者 / Spaced repetition(CC BY-SA 4.0);视频案例:TED / Angela Lee Duckworth,Grit: The Power of Passion and Perseverance,由用户录制操作 GIF。素材为网页和插件操作的节选实录,无模拟翻译回复。查看录制来源。
部分浏览器基础设施基于 Saladict 的 MIT 开源代码,保留许可与署名。此案例聚焦我对 Milo 产品层、数据层、交互和请求调度的设计与实现。